

- 差分レプリケーション
- 同期間隔(データの整合性)
- 削除キャプチャ(データとレコード)
- データ型
- データ変換
- API 接続
- ファイアウォールトラバーサル
- スキーマの変更
初期レプリケーション
初めてジョブを実行すると、CData Sync はデータソースの履歴データ全体を処理します。このデータには膨大な量の情報が含まれています。そのため、Sync は、いくつかの戦略を用いて、効率、パフォーマンス、整合性を最大化します。またSync には、特定のデータセットに対して同期戦略を最適化するために使用できるユーザー制御のオプションも用意されています。 特定のスナップショット設定を使用して、Sync が初期レプリケーションを処理する方法を制御できます。これらの設定は、ジョブの概要タブから利用できます。詳しくは、最初のレプリケーションジョブの設定を定義を参照してください。差分レプリケーション
初期レプリケーション後、CData Sync は差分レプリケーションでデータを移動します。Sync は、毎回すべてのデータをクエリする代わりに、最後のジョブ実行時から追加、変更されたデータだけをクエリします。そして、Sync はそのデータをデータウェアハウスにマージします。この機能により作業負荷が大幅に軽減し、特に大きなデータセットを扱う場合に帯域幅の使用と同期の遅延が最小限に抑えられます。 多くのクラウドシステムはAPI を使用しており、それらのAPI からデータウェアハウスに完全なデータをプルすることは、多くの場合処理に時間がかかります。また、多くのAPI では1日単位でクオータが設定されており、毎日すべてのデータを取得したくてもできず、毎時や毎15分は不可能です。Sync はデータを差分ごとに移動させることで、遅いAPI や毎日のクオータに対処する際、非常に高い柔軟性を発揮します。 Sync は、主に2つの手法(差分チェックカラムと変更データキャプチャ)を使用して差分レプリケーションを取得します。これらの手法について、次の2つのセクションで説明します。ユーザーインターフェースでは、差分レプリケーションを制御する設定は、ジョブの概要タブにあるスナップショット設定を通じて構成されます。
差分チェックカラム
差分チェックカラムは、データを同期する際に新規または変更されたレコードを識別するためにSync が使用する、datetime またはnumeric ベースのカラムです。このカラムは、ジョブの概要タブのスナップショット設定カテゴリで選択する値タイプ(日付ベースまたは数値ベース)に対応しています。 データソースにレコードが追加または更新されるたびに、このカラムの値が増加します。Sync は抽出時にこのカラムを基準として使用し、新規または変更されたレコードのみが返されるようにします。その後、Sync はカラムの新しい最大値を保存し、次のレプリケーションで使用できるようにします。 差分チェックカラムを使用するレプリケーションは、レコードが追加または更新されるにつれて値が時間の経過とともに増加するカラムに依存します。このカラムは、(前述の)スナップショット設定で選択する値タイプに対応します。- 日付ベースの差分チェックカラム: 行が最後に変更された日時を記録するdatetime カラム(Last Modified やDate Updated など)。Sync はこの値を使用して、最後のレプリケーション以降に追加または更新されたレコードを取得します。
- 数値ベースの差分チェックカラム: レコードが作成または更新されるたびに値が増加する数値カラム(自動増分識別子など)。Sync はこの値を使用して、最後に処理した値以上の値を持つレコードを取得します。
差分チェックカラムの順序付き処理
差分チェックカラムによる並べ替えをサポートしているデータソースでは、Sync は以下のレプリケーション動作を使用します:- 順序付きソースクエリ: Sync はチェックカラムの値に基づいてレコードが順番に返されるように、ソースクエリに ORDER BY 句を追加します。
- 最小値の検索: Sync は結果セット全体をスキャンするのではなく、ORDER BY … LIMIT 1 を使用してチェックカラムの最小値を取得します。
- 差分バッチコミット: Sync は、レプリケーション全体を単一のトランザクションとして扱うのではなく、完了したバッチを順次同期先にコミットします。レプリケーションジョブが中断された場合、コミット済みのバッチは保持されます。
- 差分ステータス更新: 各バッチが正常に完了するたびにステータステーブルが更新されます。レプリケーションジョブが中断された場合、次回の実行は最後に正常に完了したバッチから再開されます。
- バッチレベルのマージ: Sync は各バッチが完了するたびに同期先テーブルを更新し、対応するステータス情報を記録します。
変更データキャプチャ
一部のデータソースでは変更データキャプチャ(CDC)をサポートしており、データソースはログファイルを使用して、データベースに変更を加えるイベント(Insert、Update、またはDelete)をログに記録します。Sync は、データソーステーブルに変更をクエリするのではなくログファイルを読み込んで変更イベントを確認します。次に、アプリケーションはレプリケーションのためのそれらの変更を抽出し、次回のレプリケーション用に現在のログを保存します。
CDC 機能をサポートするデータソースの一覧については、変更データキャプチャを参照してください。
時間ベースの差分フィルタリング関数
CData Sync は時間ベースの差分レプリケーション用に以下の2つの特別な関数をサポートしています:- REPLICATE_LASTMODTIME(): ステータステーブルに保存された最後の値を返します。値が存在しない場合は、Sync はレプリケーション開始日(ReplicateStartDate)をデフォルト値として使用します。
- REPLICATE_NEXTINTERVAL(): ReplicateInterval およびReplicateIntervalUnit パラメータに基づいて、次の値を返します。これらのパラメータが設定されていない場合は、Sync はエラーを生成します。
- すべてのフィルタカラムが関数を使用している場合、Sync はREPLICATE_NEXTINTERVAL() の値を保存します。
- すべてのフィルタカラムが通常のカラムの場合、Sync は返される最大値を保存します。
- フィルタカラムが混在している場合、Sync はREPLICATE_NEXTINTERVAL() の値を保存します。
並列処理
CData Sync ジョブが並列処理を使用するように設定できます。これは、アプリケーションが1つのジョブを処理するために複数のワーカースレッドを使用することを意味します。並列処理により、Sync はワークロードを複数のプロセスに分割し、複数のテーブルを同時に移動できるようにします。その結果、より少ない時間でより多くのデータが移動され、ジョブ効率が大幅に向上します。Sync では、ジョブ単位で必要な数のワーカーを割り当てることができます。 並列処理を有効化するには:- 実行するジョブをクリックします(Sync のジョブページから)。このアクションによりジョブ/任意のジョブ名ページが開きます。
-
概要タブの設定カテゴリで、設定を編集アイコン(

- 並列処理プロパティで有効化を選択します。
-
ジョブに割り当てるワーカー数をワーカープールフィールドに入力します。この値は、一度に並列に実行できるタスクの数を制御します。
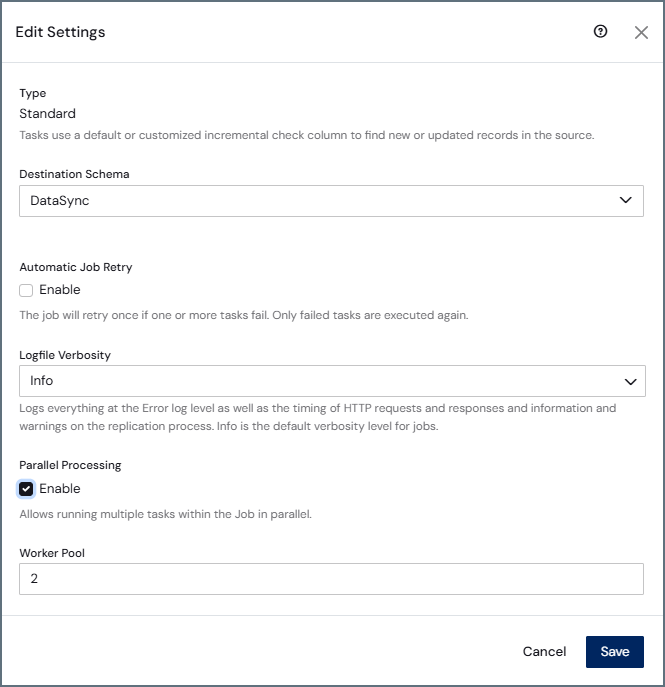
- 変更を保存(ジョブ設定ヘッダーバー右上)をクリックします。
メタデータキャッシュ
CData Sync におけるメタデータキャッシュは、データソーステーブルと同期先テーブルの構造情報を保存し、システムがそれらをジョブ間で再利用できるようにするメカニズムです。メタデータキャッシュは、Sync がデータソースや同期先に対して継続的にクエリしてテーブル構造を取得する必要をなくすことにより、パフォーマンスを向上させます。メタデータをメモリやローカルストレージですぐに利用できるようにしておくことで、キャッシュ機能は、特にストレージが低速であったり、ネットワーク応答時間が遅い外部データソースや同期先への繰り返しクエリを減らし、パフォーマンスを向上させます。この機能により、ファイルアクセスの高速化、データ取得の迅速化、システム全体の応答性の向上が実現されます。 Sync アプリケーションでは、コネクタ単位でメタデータキャッシュを有効化します。メタデータキャッシュをサポートするデータソースまたは同期先コネクタを設定する際はいつでも、下図に示すようにコネクタの新規接続ページの設定タブの下部でそのプロパティを設定できます: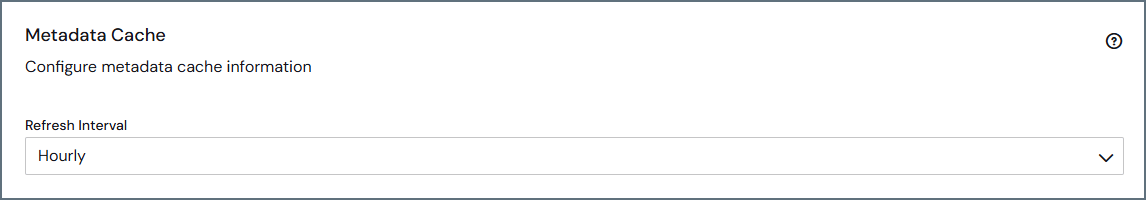
- なし: メタデータはリフレッシュされません。
- ジョブの開始時: ジョブの開始時にメタデータがリフレッシュされます。
- 毎時(デフォルト):1時間経過後にメタデータがリフレッシュされます。
- 毎日: 1日経過後にメタデータがリフレッシュされます。
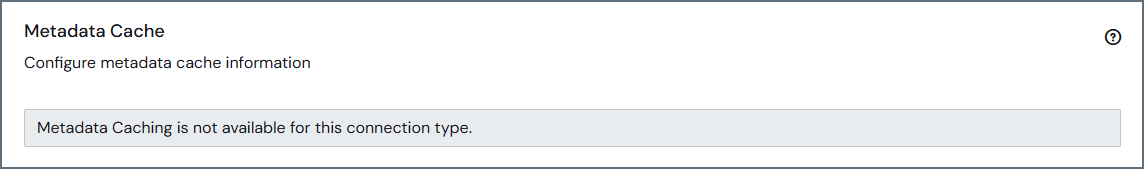
キャッシュされたメタデータは、すべてのスキーマ変更をリアルタイムで自動検出するわけではないため、データソースまたは同期先テーブルの構造が変更された際は、Sync ジョブでキャッシュをリフレッシュする必要があります。例えば、カラムの追加、削除、またはデータ型の変更が行われた場合は、リフレッシュボタン(
ジョブの自動再試行
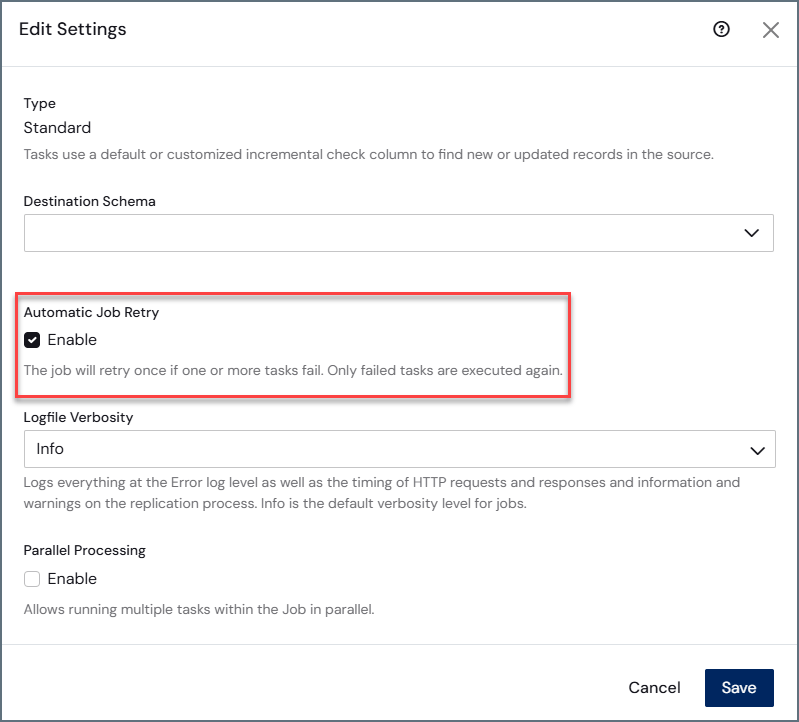
CData Sync は、一部成功ステータスで完了したタスク、またはタスクエラーやネットワークの問題で失敗したタスクの再実行を試みるジョブの自動再試行機能を提供します。ジョブの自動再試行処理は、ジョブ内の対象となるタスクにのみ適用されます。例えば、1つのタスクが失敗した場合、処理はその1つのタスクのみを再試行します。 このプロセスはすべての失敗したジョブ(キャンセルされたジョブを除く)に対して機能しますが、再試行が行われるのはそのようなジョブに対して一度のみです。 ジョブの自動再試行機能を有効にするには:- ジョブページでジョブの名前をクリック(または … > 編集を選択)して、任意のジョブ名 の設定ページを開きます。
-
概要タブの設定カテゴリで、設定を編集アイコン(
-
ジョブの自動再試行設定の有効化チェックボックスを選択します。次に、保存をクリックして設定の更新を保存します。
同期間隔(データの整合性)
データ統合戦略の一環として、元となるデータソースと同期先の間で、データの整合性を確保することが重要です。データパイプラインでエラーが発生した場合、またはジョブが中断された場合、データパイプラインプロセスを停止したところから再開する必要があります。この動作により、更新間やエラー発生時にデータが失われないことが保証されます。データ読み込みのための複雑なスクリプトやプロセスを設定することなく、CData Sync が自動的にそのアクションを管理します。 Sync は同期間隔に従ってデータを処理します。つまり、データをすべて一度に移動するのではなく、Sync がデータを扱いやすい間隔(またはデータの「チャンク」)に分割して、一度に1間隔ずつ処理します。この機能によって性能が大幅に向上し、エラーの際にもSync のデータの整合性が保たれます。Sync はデータソーステーブルと同期先テーブルを一致させます。エラーが起きた場合には、Sync は現在の間隔のデータをすべて捨ててその時点から処理を再開できます。 例えば、大規模なsync ジョブの完了間近にエラーが起きたとしましょう。Sync は最初からジョブ全体を開始するのではなく、最後に処理が完了した間隔から再開するので、時間とリソースを節約できます。API によっては、一定期間内にアクセスできる回数を制限するアクセス制限を設けているものがあります。これらの制限により、エラーが発生することがあります。このようなエラーが発生した場合、Sync は不完全なsync レコードを破棄し、次にスケジュールされたジョブでその時点から再開します。間隔の大きさを設定し、各間隔で取得するデータ量を決定し、エラーが発生した場合に移動する必要があるデータ量を制限することができます。
レプリケーションステータステーブル
Sync は、CDATA_REPLICATE_STATUS テーブルを使用して、各ジョブのレプリケーション状態を追跡します。このテーブルは、従来のレプリケーションステータステーブルに置き換わるものです。- 新規インストールでは、CDATA_REPLICATE_STATUS が自動的に使用されます。
-
既存のインストールでは、Sync のUI で各ジョブを移行するよう求められます。既存のステータステーブルは、各ジョブが移行されるまで引き続き利用でき、移行の完了後に削除されます。
- Sync が、既存のレプリケーションステータステーブルを現在の統合形式にアップグレードできることを検出すると、UI に通知が表示されます。ジョブレポートの改善(新しい一部成功タスクステータスなど)を活用するために、ステータステーブルのアップグレードをお勧めします。
- カスタムレポートや自動化でレプリケーションステータステーブルを使用している場合は、移行後にそれらのプロセスを更新して、CDATA_REPLICATE_STATUS を参照するようにしてください。
削除キャプチャ
CData Sync は削除されたレコードを自動でキャプチャして、同期先データの精度を保ちます。Sync はAPI 呼び出しや変更の追跡機能を使用して、削除されたレコードのリストをデータソースから取得します。 データソースがSync に対して削除されたデータの検出を許可している場合は、高度なジョブオプションで説明するように、削除の挙動オプションを使用してSync による削除の処理方法を制御できます。- Hard Delete(デフォルトパラメータ):データソースで削除が検出されると、Sync は同期先のテーブルからそのレコードを削除します。
- Soft Delete:Sync は同期先テーブルに _cdata_deleted カラムを追加します。データソースで削除が検出されると、Sync は同期先の値をtrue に設定します。
- Skip Delete:Sync はデータソースで削除されたレコードを無視します。
データソース情報に記載されているとおり、API によっては削除されたレコードの検出をSync に許可しません。
データ型
CData Sync は多くのデータ型を認識し、データ型が厳密に定義できない場合には、Sync はデータに基づいてデータ型を推論します。Sync は次のデータ型を認識します。- Boolean
- Date
- Time
- TimeStamp
- Decimal
- Float
- Double
- SmallInt
- Integer
- Long
- Binary
- Varchar
- GUID
既知のデータ型
多くのデータソース(主にリレーショナルデータベース(SQL Server、Oracle など)および一部のAPI)について、Sync は自動的にスキーマ用のデータ型を検出します。データソースのカラムのデータ型が既知の場合、Sync は自動で一致するデータ型を同期先に作成します。推論されたデータ型
データ型が指定されていない場合、Sync はカラムのデータ型を決定するためにデータの最初の数行を解析して、データ型を推論できます。 Sync が不明なカラムサイズの文字列型を検出した場合、カラムのデフォルトサイズは2000となります。SQL Server のようなリレーショナルデータベースでは、Sync はこの型用にvarchar(2000) フィールドを作成します。 データ型が厳密に定義されていないフィールドの場合、Sync は最初の行を読み取り、各カラムの最小のデータ型を自動的に選択します。その後、アプリケーションは次の行を読み取り、データが選択したデータ型で格納できるかを確認します。データが収まらない場合、Sync はデータ型のサイズを増やします。Sync は、これを行スキャンの深度(RowScanDepth - 50または100行)まで実行します。これが終了すると、Sync はデータ型を持っています。 例えば、CSV のようなデータソースでは、Sync はRowScan を使用してファイルの最初の数行を読み取り、動的に各カラムのデータ型を決定します。変換
データパイプラインにおいて変換は、レポーティングやデータ分析を容易にするためにデータを加工、整形、集計する方法の1つです。Sync は、データパイプラインを構築する際にデータ変換を管理する2つの一般的な手法をサポートしています。- ETL: ETL(extract(抽出)、transform(変換)、load(ロード))処理は数十年にわたってアナリティクスの伝統的な手法となっています。ETL は、歴史的に市場を席巻してきたリレーショナルデータベースでの使用を想定して考案されました。ETL では、レプリケーション処理の前に変換を行う必要があります。データはデータソースから抽出され、ステージングエリアに格納されます。データは整形、修飾、変換されてデータウェアハウスにロードされます。ETL についての詳細は、In-Flight ETLを参照してください。
- ELT: ELT(extract(抽出)、load(ロード)、transform(変換))処理は、変換などのデータの変更がレプリケーション処理後に行われるデータ抽出の手法です。現代のクラウドデータウェアハウスは膨大なストレージとスケーラビリティを備えているため、データすべてを移動して、その後修正を加えることができます。 ELT 変換はデータの同期先で実行されるSQL スクリプトです。変換はデータウェアハウスの処理能力を使って、アナリティクスとレポーティング面でのニーズに基づき素早くデータを集計、結合、整形します。データを変換とマッピングで整理することで、パイプラインの移動に合わせてデータを最も役立つ形式で取得できます。ジョブ同様、変換はセミコロン(;)で区切られた複数のクエリをサポートし、スケジュールに従って実行し、変換の完了後にE メールアラートが送信されます。ELT についての詳細は、Post-Job ELTを参照してください。
個人情報のマスキング
個人情報(PII)のマスキングは、データベースやデータテーブル内の機密情報のプライバシーとセキュリティを強化するデータ保護技術です。PII には、名前、住所、社会保障番号、その他個人を特定できるデータが含まれます。 マスキングは、PII を含む特定のカラム内の実際のデータを非表示にすることで、そのカラムへのアクセスを制限します。Sync においては、マスキングはポイントアンドクリックの変換オプションです。Sync でデータをマスクすると、データの各文字はアスタリスク(*)に置き換えられます。マスキングは一方向の操作です。つまり、一度マスキングを適用すると、データを以前の状態に戻すことはできません。マスキングは、EU 一般データ保護規則(GDPR)、US 医療保険の相互運用性と説明責任に関する法律(HIPAA)など、個人情報や機密情報の安全な取り扱いを義務付けるデータ保護規制を遵守するために重要です。 マスキングおよびその他の変換オプションの詳細については、SQL Transformation の適用を参照してください。ヒストリーモード
CData Sync のヒストリーモードは、データソース内の履歴データを分析するための方法を提供します。ヒストリーモードは、データウェアハウスの比較的静的なデータ(現在および履歴)を保存および管理するslowly changing dimensionです。そのデータは、時間の経過とともにゆっくりと(しかし予測不可能に)変化することがあります。 CData では、ヒストリーモード(ヒストリーモードプロパティ)を使用してデータ行(レコード)の変更履歴を追跡し、データが時間の経過とともにどのように変化するかを確認できます。ヒストリーモードは、データソース接続が差分レプリケーションをサポートしている場合、すべてのCDC と標準ジョブで利用可能です。 CData は、履歴データを分析するための複合アプローチをサポートしています。つまり、ヒストリーモードプロパティは、監査のための堅牢な追跡と時系列分析の両方を提供します。 ヒストリーモードはテーブル単位で機能します。そのため、どのテーブルを分析するかを決定し、それらのテーブルに対してのみオプションを有効にできます。 標準(個別設定)モードでは、Sync は既存の行をマージして更新しますが、ヒストリーモードでは、Sync は更新された行をデータベースのテーブルに追加します。ヒストリーモードの種類
CData Sync はヒストリーモードに加えて、このモードと併用できる2つのオプション(History Mode - Append Only およびHistory Mode - Include Before Update)を提供しています。どちらのオプションも履歴データを保持しますが、以前のバージョンのレコードをどのように扱うかが異なります。次のリストでは、ヒストリーモードと2つのオプションがレコードバージョンをどのように扱うかを説明しています:- ヒストリーモード: このモードは、変更されたレコードの新しいバージョンを追加し、以前のバージョンのメタデータを更新して非アクティブとしてマークします。つまり、Sync はソースデータベーステーブルの各データレコードに対するデータ変更の完全な履歴を保持し、それらの変更バージョンを同期先データベーステーブルの対応するテーブルに記録します。
- ヒストリーモード – 追記専用: このオプションは、変更されたレコードの新しいバージョンを追加しますが、以前のバージョンやメタデータは更新しません。同期先の古い行は変更されません。ヒストリーモード - 追記専用は、Avro、CSV、Parquet の同期先で自動的に有効になります。他のすべての同期先では、手動で有効にする必要があります。
-
ヒストリーモード - Include Before Update: このオプションを有効にすると、Sync は行の「更新前」のイメージをキャプチャします。その後、アプリケーションは更新ごとに追加のレコードを同期先に書き込みます。このオプションは、ヒストリーモード - 追記専用と併用する必要があります。
このオプションをサポートされているCDC ソースで有効にすると、Sync は更新操作ごとに2つの行を書き込みます。1つは更新前のレコードの状態を表す行で、もう1つは更新後のレコードの状態を表す行です。これらの行は、
_cdatasync_operationカラムに格納される値によって区別されます。
ヒストリーモードのシステムカラム
ヒストリーモード機能を実現するために、Sync には同期先テーブルにシステムカラムを5つまで追加することができます。標準ジョブでは3つのカラム(_cdatasync_active、_cdatasync_start、_cdatasync_end)が使用されます。変更データキャプチャ(CDC)が有効な場合、データソースのオペレーションとバージョンメタデータを記録するために、さらに2つのカラム(_cdatasync_operation、_cdatasync_version)が作成されます。
次の表は、ヒストリーモードが有効な場合にSync が追加できるシステムカラムを説明しています。
| カラム名 | カラム型 | 説明 | カラムを使用するモードとオプション |
|---|---|---|---|
_cdatasync_active | Boolean | レコードがアクティブかどうかを指定します。 | 標準(個別設定)モード、ヒストリーモード |
_cdatasync_start | Datetime | データレコードがアクティブになった時点の差分チェックカラムのdatetime 値を指定します。この値は、データ更新ごとに増加するタイムスタンプに基づいて、データソーステーブルでレコードが作成または修正された日時を示します。 | 標準(個別設定)モード、ヒストリーモード、ヒストリーモード - 追記専用、ヒストリーモード - Include Before Update |
_cdatasync_end | Datetime | データレコードが非アクティブになった時点の差分チェックカラムのdatetime 値を指定します。このカラムのNull 値は、レコードがアクティブであることを示します。 | 標準(個別設定)モード、ヒストリーモード |
_cdatasync_operation | Varchar | 使用するオペレーションを指定します:Insert (I)、Update (U)、またはDelete (D)。Note:このカラムは、変更データキャプチャ(CDC)を使用するジョブにのみ追加されます。 | ヒストリーモード、ヒストリーモード - 追記専用、ヒストリーモード - Include Before Update |
_cdatasync_version | Varchar(100) | CSRS テーブルに保存されるフォーマットの変更ごとにバージョンを指定します。Note:このカラムは、CDC を使用する場合にのみ適用されます。 | ヒストリーモード - 追記専用 |
_cdatasync_operation カラムに表示される値は、ジョブの種類と有効になっているヒストリーモードのオプションによって異なります。
標準またはSyncAll ジョブの場合:
- M: マージ操作の一環として行を挿入または更新します。
- D: 行を削除します。
- I(Insert):この値は、行がソースシステムに挿入されたことを記録します。ソースの操作が判明している場合、Sync はこの値を使用して挿入イベントを記録します。
- U(Update)
- D(Delete)
- BU(Before Update):ヒストリーモード - Include Before Updateが有効な場合に、更新が発生する前の行の状態を表す値です。
制限事項
ヒストリーモードでは次の制約が適用されます。- データソーステーブルは差分チェックカラムをサポートしている必要があります。
- ソーステーブルに主キーが含まれている必要があります。(ヒストリーモード - 追記専用の場合、主キーは必須ではありません。)
- 差分チェックカラムがタイムスタンプ(datetime)カラムである必要があります。
- 疑似カラムはレスポンスに値を持たず条件としてのみ使用されるため、差分チェックカラムを疑似カラムにすることはできません。
- 同期先テーブルは存在できません。(ヒストリーモードがアクティブな場合、高度な設定タブのテーブルを削除設定を使用してテーブルを再作成します。)
ジョブおよびタスクのヒストリーモードを有効化する
ジョブのヒストリーモードを有効にするには:- ジョブタブをクリックしてジョブページを開きます。
- ジョブ名をクリックして概要ページを開きます。次に、高度な設定タブをクリックします。
- レプリケートオプションカテゴリで、レプリケートオプションを編集アイコン(

- ヒストリーモードオプションまでスクロールします。ヒストリーモードオプションを有効にするには、有効化を選択します。有効にすると、Sync はデータソースで発生するすべての変更に対してタイムスタンプ付きのエントリを同期先に追加します。(オプションを無効にする場合は、有効化チェックボックスをオフにします。)
- 保存をクリックします。
- ジョブのタスクタブをクリックします。
- 変更するタスクの名前をクリックします。次に、高度な設定タブをクリックします。
-
レプリケートオプションカテゴリで、編集アイコン(
-
ヒストリーモードオプションまでスクロールします。タスクは、関連するジョブのヒストリーモードステータスを継承します。
- ヒストリーモードのステータスが有効化済み(継承) に設定されている場合、その設定をオーバーライドしない限り変更は必要ありません。
- ヒストリーモードが未有効化(継承) でこのタスクに対して有効にしたい場合は、ダイアログボックスの上部にスクロールしてジョブ設定をオーバーライドを選択します。その後、ヒストリーモードに戻り、有効化を選択します。
関連するテーブルが差分チェックカラムをサポートしていない場合、タスク設定でヒストリーモードは無効になります。 - 保存をクリックします。
ジョブおよびタスクのヒストリーモード - 追記専用を有効化する
ジョブまたはタスクでHistory Mode - Append Only オプションを使用するには、まずヒストリーモードを有効にしてから、History Mode – Append Only を有効にする必要があります。 ジョブのヒストリーモード - 追記専用を有効にするには:- ジョブタブをクリックしてジョブページを開きます。
- ジョブ名をクリックして概要ページを開きます。次に、高度な設定タブをクリックします。
-
レプリケートオプションカテゴリで、レプリケートオプションを編集アイコン(
-
ヒストリーモードオプションまでスクロールし、すでに有効になっていることを確認します(オプションラベルが有効化済み(継承) と表示されているはずです)。有効になっていない場合は、手順5に進む前にジョブのヒストリーモードを有効にする手順を実行してください。
関連するテーブルが差分チェックカラムをサポートしていない場合、タスク設定でヒストリーモードは無効になります。
-
レプリケートオプションを編集ダイアログボックスの下部にある追加オプションテキストボックスまでスクロールし、
HistoryModeAppendOnly=trueオプションを追加オプションテキストボックスに入力します。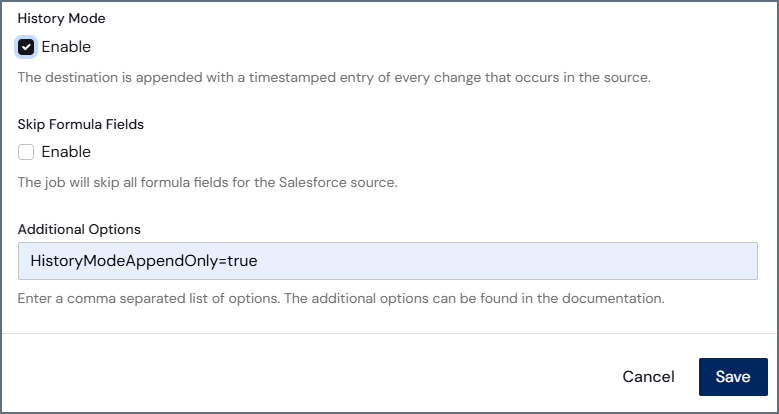
- 保存をクリックします。
- ジョブのタスクタブをクリックします。
- 設定するタスクの名前をクリックします。次に、高度な設定タブをクリックします。
-
レプリケートオプションカテゴリで、編集アイコン(
-
ヒストリーモードオプションまでスクロールし、すでに有効になっていることを確認します(オプションラベルが有効化済み(継承) と表示されているはずです)。有効になっていない場合は、手順5に進む前にジョブおよびタスクのヒストリーモードを有効にする手順を実行してください。
関連するテーブルが差分チェックカラムをサポートしていない場合、タスク設定でヒストリーモードは無効になります。
-
レプリケートオプションを編集ダイアログボックスの下部にある追加オプションテキストボックスまでスクロールし、
HistoryModeAppendOnly=trueオプションを追加オプションテキストボックスに入力します。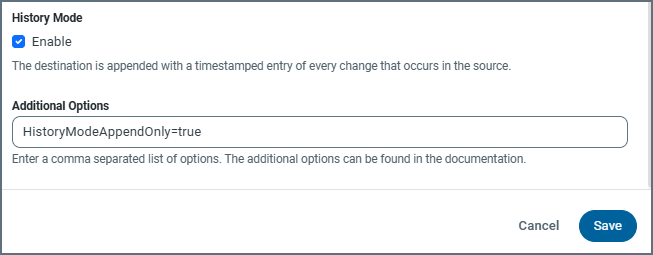
- 保存をクリックします。
ジョブおよびタスクのヒストリーモード - Include Before Update を有効化する
History Mode - Include Before Update オプションを使用すると、行の「更新前」のイメージをキャプチャできます。このオプションを有効にすると、Sync は更新ごとに追加のレコードを同期先に書き込みます。History Mode - Include Before Update は、次の両方の条件が満たされている場合にのみ適用されます:- History Mode - Append Only モード(
HistoryModeAppendOnly=true)を使用している。 - ソースがCDC を使用している。
- ジョブタブをクリックしてジョブページを開きます。
- ジョブ名をクリックして概要ページを開きます。次に、高度な設定タブをクリックします。
-
以下のセクションの手順に従って、ヒストリーモードとHistory Mode - Append Only が有効になっていることを確認します:
History Mode - Include Before Update をtrue(
HistoryModeIncludeBeforeUpdate=true)に設定してもHistory Mode - Append Only を有効にしていない場合、Sync はHistoryModeIncludeBeforeUpdateがHistoryModeAppendOnly=trueが有効な場合にのみ使用できる旨を示すエラーを生成します。 -
ジョブの高度な設定タブで、レプリケートオプションカテゴリの編集アイコン(
-
以下に示すように、
HistoryModeIncludeBeforeUpdate=trueオプションを追加オプションテキストボックスに入力します: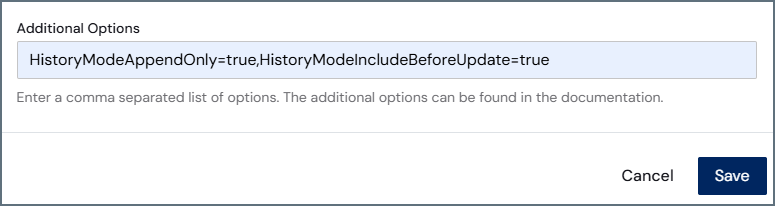
- 保存をクリックします。
- ジョブのタスクタブをクリックします。
- 設定するタスクの名前をクリックします。次に、高度な設定タブをクリックします。
- 以下のセクションの手順に従って、ヒストリーモードとHistory Mode - Append Only が有効になっていることを確認します:
-
ジョブの高度な設定タブで、レプリケートオプションカテゴリの編集アイコン(
-
以下に示すように、
HistoryModeIncludeBeforeUpdate=trueオプションを追加オプションテキストボックスに入力します: - 保存をクリックします。
- 更新前の状態を表す行。
_cdatasync_operationはBU に設定されます。 - 更新後の状態を表す行。
_cdatasync_operationはU に設定されます。
データソーステーブルを変更した場合の影響
行を挿入、更新、削除してデータソーステーブルを変更すると、次の表で説明するように、同期先はさまざまな形で影響を受けます。| データソースの変更 | 同期先の影響 |
|---|---|
| 挿入された行 | 同期先テーブルに行が追加されます。_cdatasync_active はTrue に設定され、_cdatasync_start は差分チェックカラムの値に設定されます。 |
| 更新された行 |
|
| 削除された行 | 同期先の現在の行が更新されます。_cdatasync_active はFalse に設定されます。 |
_cdatasync_operation をBU に設定して記録されます。
API 接続
CData Sync にはビルトインのREST(representational state transfer) API が含まれており、アプリケーションの柔軟な管理を実現します。管理コンソールのUI で実現できることはすべて、RESTful API コールで実現できます。 Sync は2つのREST API バージョンを提供します:- Sync API V2 は、7つのAPI で構成されています:
- 接続管理API
- イベント管理API
- ジョブ管理API
- パイプライン管理API
- 変換管理API
- ユーザー管理API
- ワークスペース管理API
- Sync API V1 は、3つのAPI で構成されています:
- ジョブ管理API
- 接続管理API
- ユーザー管理API
In-Network インストール
CData Sync はどこでも実行できるため、クラウド上にあるシステムと社内ネットワーク上にあるシステムを持つユーザーにとって最適なアプリケーションです。Sync をインストールしてネットワーク内で実行できるため、インターネットや開いたファイアウォール経由でポートが公開されたり、VPN 接続を作成したりすることを回避できます。 また、Sync アプリケーションをどこでも実行できることで、遅延を大幅に削減することができます。データソースや同期先の近くでSync を実行できるため、ETL やELT ジョブのパフォーマンスが向上します。スキーマの変更
データは常に変化していますが、Sync はそれらの変化を常に正確に表すことを保証します。毎実行時、CData Sync はデータソースのスキーマと同期先のスキーマを比較して差分を検出します。Sync が2つのスキーマ間で構造の違いを検出した場合、アプリケーションは同期先のスキーマを変更し、以下で説明するようにデータソースのデータを格納できるようにします。- データソーステーブルに同期先テーブルに存在しないカラムが含まれている場合、Sync はカラムを追加することで同期先テーブルを変更します。
- データソーステーブルのデータ型のサイズが増える場合、Sync はカラムのサイズを更新することで同期先テーブルを変更します。Sync は、文字列カラムのカラムサイズを増やしたり(例:varchar(255) -> varchar(2000))、非文字列カラムのバイトサイズを増やす(例:smallint -> integer)、といった変更を行います。
- Sync は、カラムがデータソーステーブルから削除されている場合でも、同期先テーブルからはカラムを削除しません。
- Sync は、データソースでデータ型のサイズが更新された場合でも(varchar(2000) -> varchar(255))、同期先カラムのサイズは小さくしません。